Che cosa è Internet.
Internet è il nome con cui si designa comunemente la più grande rete di
calcolatori esistente al mondo oggidì. In generale una rete di calcolatori
è un insieme di computers collegati eventualmente tra loro attraverso vari tipi di
canali di trasmissione dati (cavi metallici, fibre ottiche, rete telefonica, etere,
eccetera), i quali comunicano tra loro usando un determinato "linguaggio" chiamato
linguaggio della rete. Il linguaggio di Internet si chiama Internet
Protocol Suite o più comunemente TCP/IP. Si può
così dire che Internet è la rete di tutti i computer sparsi per tutto il
mondo che "parlano" il linguaggio TCP/IP. È possibile
rappresentare logicamente e graficamente Internet (o più in generale una rete
qualsiasi) con un oggetto matematico chiamato grafo. Possiamo dire che un grafo sia un
insieme di punti del piano (detti nodi del grafo) collegati eventualmente da segmenti
(detti archi del grafo). Nel nostro caso i nodi rappresentano i computer di Internet e gli
archi rappresentano gli eventuali canali fisici di trasmissione che connettono due
computers. Possiamo quindi immaginare che Internet sia una rete come quella in figura.
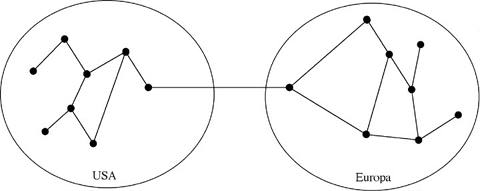
In realtà è più proprio dire che Internet è la rete delle reti
locali (chiamate LAN); quindi, in figura, ogni nodo, in realtà
più propriamente, rappresenta una LAN.
Per approfondire si veda Internet & Computing Italian FAQ di V. Bertola,
Paragrafo 2.1.
A che serve Internet.
Internet serve per potersi scambiare informazioni binarie di vario tipo usando i vari
linguaggi, o più propriamente protocolli di comunicazione, che costituiscono il
TCP/IP. Questo scambio di informazioni avviene sotto varie forme a
seconda dei vari tipi di servizi che internet offre. Ogni servizio viene fornito usando
un particolare protocollo del TCP/IP e tutti i protocolli sono comuni
a tutta la rete Internet; tant'è che la caratterizzano dal punto di vista logico.
Breve storia di Internet.
Il suo primo nucleo è stato creato dal Dipartimento della Difesa degli Stati Uniti
per scopi militari negli anni '60 (DARPA Net). Dopodichè è stato preso in
gestione dal mondo accademico americano che ne ha capito le potenzialità e lo ha
sviluppato. Il suo obbiettivo era quello di far sì che le Università e gli
istituti di ricerca sparsi per il mondo potessero comunicare facilmente e collaborare
nelle proprie ricerche, condividendo dati, documenti, programmi, calcolatori e risorse in
genere. È solo dagli inizi degli anni '90 che Internet è stato aperto a
tutti; ed in particolare, ad enti non universitari o governativi (associazioni, aziende,
venditori di accessi, eccetera).
Per approfondire si veda Internet & Computing Italian FAQ di V. Bertola,
Paragrafo 2.3. e
Paragrafo 3.1.
Che cosa è il World Wide Web.
Oggi, Il più famoso servizio offerto da Internet (che indubbiamente è stato
causa del suo fortissimo sviluppo negli anni '90) è quello che comunemente si
chiama navigazione sul World Wide Web. Il World Wide Web
(ragnatela mondiale) o brevemente Web o WWW o W3, è l'insieme di tutti gli
iperoggetti multimediali (in inglese, hypermedia)
fisicamente residenti nelle memorie delle varie macchine dI Internet e collegati tra loro
con dei rimandi o, più propriamente, dei link. Gli
iperoggetti multimediali del World Wide Web prendono
il nome comunemente di pagine Web.
Che cosa è un iperoggetto multimediale.
Un iperoggetto multimediale è un file multimediale
ed iperoggetto.
Che cosa è un file multimediale.
Un file multimediale è un file che consente di trasmettere conoscenza usando vari
mezzi di comunicazione, quali ad esempio audio, immagini, testi, filmati, algoritmi,
eccetera. L'uomo si scambia informazioni per scambiarsi la conoscenza e quindi per
apprendere (ovvero, aumentare la sua conoscenza). Egli ha sempre trasmesso conoscenza sin
dai tempi preistorici e questa trasmissione è avvenuta mediante dei mezzi di
comunicazione che si sono andati via via sempre piu raffinando. Il primo mezzo di
comunicazione che sia stato "inventato" è la parola o i suoni in genere. Sono cose
talmente primordiale che addirittura gli animali le usano per comunicare. Poi è
venuto il mezzo di comunicazione mediante immagini. Si pensi, ad esempio, all'uomo
preistorico che raffigurava gli animali che vedeva sulle pareti della caverna. Con
l'avvento dell'era stroica, è stato inventato il mezzo di comunicazione della
scrittura. Anzi, si può dire che l'inizio dell'era storica sia stata
caratteerizzata dall'invenzione della scrittura. Questi tre mezzi di comunicazione si
sono andati sempre più raffinando ma sono stati sostanzialmente gli unici modi di
comunicare fino alla fine dell'ottocento quando è stato scoperto il cinema (=
immagini in movimento) prima muto e poi con il sonoro.
Un altro mezzo di comunicazione che è stato inventato negli ultimi 50 anni grazie
allo sviluppo dei calcolatori e del concetto di algoritmo, è quello della
"comunicazione tramite algoritmi". Questo mezzo di comunicazione trasmette informazione
(i.e., una sequenza binaria che "trasporta" della conoscenza) trasmettendo un'algoritmo
che genera l'informazione (i.e., la sequenza binaria) stessa. Un esempio esplicito di
questo è, per esempio, dato dai cosiddetti applets. Un applet è un
programma (di solito scritto nel linguaggio di programmazione Java) che viene inserito in
pagine Web ed eseguito quando l'utente carica tali pagine. Per poter utilizzare questi
programmi è necessario disporre di un browser con
incorporate le capacità di un interprete Java (un interprete e un programma che
traduce il codice Java contenuto nell'applet nel linguaggio macchina della macchina locale
e lo manda in esecuzione. Queste azioni di traduzione ed esecuzione vengono fatte
istruzione per istruzione). Da questo punto di vista, una cosa analoga può essere
ottenuta con i programmi scritti nel linguaggio Javascript. Un altro esempio eclatante di
comunicazione tramite algoritmi è dato dai cosiddetti "self extracting archives"
(archivi auto estraenti). Un self extracting archive è null'altro che un file
compresso a cui è stato attaccato l'agoritmo di decompressione. Ogni volta che
vedete un file con l'estensione ".sea" significa che il file è un self extracting
archive. Basterà cliccarci sopra due volte per decomprimerlo. In generale, si
tenga presente che ogni file multimediale interattivo (interattivo significa che
ciò che appare sullo schermo nel tempo dipende da una sequenza di azioni intraprese
dall'utente) ha incorporato della programmazione e quindi definisce una comunicazione
tramite algoritmi. Come esempio di ciò si pensi alle enciclopedie multimediali
oggidì esistenti.
In definitiva, quindi, un file multimediale è null'altro che un file che se
visualizzato con un browser od un altro programma apposito,
trasmette conoscenza usando tutti i mezzi di comunicazione su menzionati e tutti gli
altri che verranno in futuro.
Che cosa è un iperoggetto.
Un iperoggetto è un file che contiene dei rimandi o links ad altri iperoggetti.
Una volta visualizzato il file con un browser, un
link si presenta come una zona "eccitante" dello schermo nel
senso che se si punta la zona con il cursore, il puntatore del mouse si trasforma in una
manina che indica, e cliccando su tale zona compare un altro iperoggetto od un altro file
in genere. Fisicamente un link è null'altro che l'indirizzo
URL dell'oggetto (= dove si trova in Internet e come si manipola) a cui il link si
riferisce.
Per approfondire si veda Internet & Computing Italian FAQ di V. Bertola,
Paragrafo 2.4.
Cosa significa navigare sul Web e come si fà.
Le pagine Web vengono visualizzate da apposite applicazioni chiamati browsers. Navigare
sul Web significa visualizzare una sequenza di pagine Web passando da una pagina alla
successiva cliccando sui link che le collegano. Oggidì i browsers più
famosi sono Netscape Communicator (della Netscape Corporation) ed Internet Explorer (della
Microsoft).
Per approfondire si veda Internet & Computing Italian FAQ di V. Bertola,
Paragrafo 2.5. e
Paragrafo 2.6.
Che cosa è il TCP/IP o Transfer Protocol Suite (collezione di protocolli
Internet).
La comunicazione in Internet avviene tra coppie di computer: client e server, nella
"lingua" definita dai protocolli TCP/IP. Tale collezione di protocolli di comunicazione
prende il nome di Transfer Protocol Suite. Brevemente, un client è un computer
della rete che ha bisogno di informazioni o di un servizio in genere ed il server
è un altro computer della rete che gli fornisce le informazioni od il servizio.
Quindi, Internet in sè è solo un mezzo che permette a più coppie di
computer di dialogare tra loro. Su Internet, difatti, il dialogo avviene normalmente a
coppie (struttura "client - server"): sebbene un computer possa dialogare
contemporaneamente con più suoi simili, ciascun messaggio ha uno e un solo
destinatario alla volta. Il dialogo tra due computer è qualcosa di piuttosto
complesso e può avvenire a vari livelli: semplificando, un livello "basso" è
quello dello scambio di informazioni binarie (spedizione di 1 e 0 lungo i cavi che
costituiscono la rete), un livello "alto" è quello dello scambio di oggetti
informatici (iper o no: un ipertesto (= testo con links), un'immagine,
un programma...). Tuttavia, a qualsiasi livello avvenga il dialogo, è necessario
che i due computer sappiano esattamente quali convenzioni seguire durante il suo
svolgimento, ossia con quale linguaggio parlarsi, altrimenti non si capirebbero: un
protocollo di comunicazione è proprio un insieme di procedure standard di
comunicazione.
Su Internet viene usato, a scopi diversi, un gran numero di protocolli diversi, che nel
loro complesso sono generalmente indicati come protocolli TCP/IP (anche se il nome
corretto, che nessuno usa, è Internet Protocol Suite ossia collezione di protocolli
Internet). Mentre ai livelli più bassi (gestiti automaticamente dal vostro
software di comunicazione) si utilizzano quasi sempre i due protocolli
TCP e IP (non lasciatevi confondere: sono
due protocolli che fanno parte, insieme ad altri, dell'insieme di protocolli TCP/IP), ai
livelli più alti esistono diversi protocolli che possono essere seguiti, ciascuno
mirato al trasferimento di oggetti diversi o anche di oggetti uguali ma in modo diverso.
È allora necessario conoscere almeno i più comuni per poter accedere a tutte
le informazioni normalmente reperibili sulla rete!
I principali protocolli di "alto livello" usati su Internet sono (gestiti da applicazioni
specifiche):
| HTTP
| HyperText Transfer Protocol
| Trasferimento di iperoggetti e altri file nell'ambito del WWW
|
| FTP
| File Transfer Protocol
| Copia di file binari o di testo (ASCII) da un sito remoto
|
| Telnet
|
| Controllo di computer a distanza
|
| SMTP
| Simple Mail Transfer Protocol
| Spedizione di messaggi di posta elettronica
(E-mail e mailing lists)
|
| POP3
| Post Office Protocol 3
| Gestione delle caselle di posta elettronica
|
| NNTP
| Network News Transfer Protocol
| Trasferimento di articoli di newsgroup
|
| IRC
| Internet Relay Chat
| Dialogo tra utenti di Internet in tempo reale tramite messaggi digitati sulla
tastiera
|
I protocolli di "basso livello" usati su Internet sono (gestiti dai programmi del TCP/IP
stack (=insieme dei programmi del sistema operativo che si occupano della connessione ad
Internet):
| TCP
| Transmission Control Protocol
| Controllo e preparazione dati per la trasmissione nella comunicazione tra
client e server
|
| IP
| Internet Protocol
| Instradamento della trasmissione tra client e server
|
La gerarchia dei protocolli TCP/IP è rappresentata dal seguente diagramma.
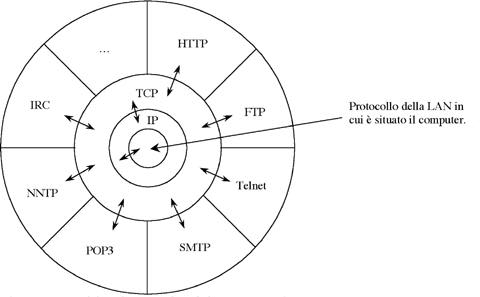
Un oggetto posto in rete è caratterizzato non solo da quello che è, ma anche
dal modo (ossia dal protocollo) con cui si può accedere ad esso! Per fare un
paragone, è perfettamente inutile che, dovendo recuperare qualcosa che mi
interessa, io sappia che esso è posto in una determinata stanza, se poi non so
quale chiave devo usare per aprirne la porta; su Internet scegliere il protocollo da usare
è un po' come scegliere la chiave. Comunque, la scelta del protocollo è
soltanto in rari casi lasciata all'utente: i programmi di posta elettronica, ad esempio,
useranno automaticamente SMTP per spedire i messaggi e POP3 per leggere quelli in arrivo.
Prima dell'avvento dei navigatori (browser) come Netscape Navigator
o Internet Explorer, ciascun protocollo richiedeva un programma apposito per essere
utilizzato; questi programmi, invece, permettono di selezionare il protocollo
semplicemente scrivendolo come parte dell'indirizzo (URL)
dell'oggetto che si vuole recuperare.
Per approfondire si veda Internet & Computing Italian FAQ di V. Bertola,
Paragrafo 3.2.
Come avviene la trasmissione dei dati in Internet; i protocolli TCP e IP.
Nel TCP/IP la trasmissione fisica dei dati avviene a pacchetti; ovvero la sequenza di dati
da trasmettere dal mittente alla destinazione viene suddivisa in segmenti e ciascun
segmento è spedito sulla rete fisica indipendentemente dagli altri. Durante la
trasmissione i protocolli TCP e IP svolgono due mansioni differenti. In particolare:
In questo modo la struttura di un pacchetto è la seguente:
| Intestazione IP (20 bytes circa) |
Intestazione TCP (20 bytes circa) |
Dati (200-1400 bytes) |
Struttura di un pacchetto
Essenzialmente la trasmissione da un computer mittente ad uno destinatario avviene secondo
un protocollo di comunicazione, chiamato protocollo di comunicazione asincrona con
acknowledgment, in cui il mittente spedisce un pacchetto nella rete. Appena il
destinatario lo riceve spedisce al mittente un segnale di acknowledgment (contenuto sempre
in un pacchetto) per dire al mittente che è pronto a ricevere un nuovo pacchetto.
Appena il mittente riceve l'acknowledgment spedisce il nuovo pacchetto. Ovviamente le
cose sono molto più complesse, ma il principio è quello appena detto.
Come avviene la trasmissione fisica di ogni pacchetto.
Internet è una enorme rete di calcolatori, formata connettendo tra loro varie reti
più piccole, alcune locali, alcune regionali, altre continentali o mondiali (magari
a loro volta formate connettendo tra loro reti più piccole...). Per questo motivo
si dice normalmente che Internet è "la rete delle reti": mentre una singola rete
locale collega tra loro vari computer, Internet collega tra loro varie reti locali. In
generale, ogni rete locale di calcolatori (LAN o Local Area Network)
è formata da un certo numero di computer collegati tra loro tramite un ben
determinato mezzo fisico (ad esempio un cavo coassiale). Una LAN può avere
strutture molto diverse: i computer possono essere collegati tra loro tramite un anello,
in cui ciascuno manda messaggi al successivo e li riceve dal precedente (rete token ring),
oppure tramite un bus (ossia, c'è un unico lungo cavo a cui sono collegati tutti i
computer, che, uno alla volta, lo usano per mandare i loro messaggi: è il caso
delle reti Ethernet, che sono il tipo più diffuso). Anche il mezzo fisico su cui
viaggiano i segnali può essere molto diverso (cavo coassiale, fibra ottica, doppino
telefonico...). Proprio perché su reti locali diverse i computer parlano
"linguaggi" diversi, a livello di trasmissione fisica, di accesso e di controllo, per
collegare una rete locale al resto della rete è necessario che ci sia un apposito
computer, detto router (indirizzatore), o anche gateway (cancello) che parli entrambi i
protocolli della LAN e di Internet (ovvero il TCP/IP). È tramite questo computer
che il LAN è collegato ad Internet. Il compito di indirizzare i pacchetti verso la
destinazione finale è assolto dal livello IP dei router che sono computer dedicati
e costruiti a questo scopo, a cui tutti gli utenti trasmettono i messaggi perché
essi vengano girati ai destinatari. Teoricamente è sufficiente un normale computer
con software adatto, ma di fatto esistono industrie che costruiscono macchine
specializzate per garantire alte prestazioni in questi campi: un normale PC non potrebbe
certo reggere efficientemente il traffico generato da un centinaio o un migliaio di altri
PC collegati alla rete....
La trasmissione in Internet avviene secondo uno schema di instradamento adattivo (adaptive
routing). Come primo passo della trasmissione, il computer dell'utente spedisce i propri
pacchetti al router che collega la sua rete locale al resto di Internet; il router a sua
volta spedisce i pacchetti a tutti i rauters ad esso fisicamente collegati che
rappresentano la "direzione migliore" verso la destinazione. A loro volta tutti questi
routers effettueranno la stessa cosa. Di router in router, alla fine i pacchetti arrivano
ad un router che è direttamente collegato alla rete locale del computer destinatario, e
vengono consegnati al destinatario.
Poiché nessuno è perfetto, tuttavia, può succedere che per qualche
motivo alcuni pacchetti continuino a girare in circolo (il router A li manda al router B,
B al router C e C ad A). Per evitare che piano piano questo tipo di pacchetti,
continuando a girare in tondo e accumulandosi, saturi la rete, ad ogni pacchetto IP
è associato un tempo di vita (time to live o TTL), che rappresenta il massimo
numero di router che esso può incontrare nel suo cammino. Ogni router attraverso
cui transita il pacchetto sottrae uno al suo tempo di vita; quando esso arriva a zero, il
pacchetto viene distrutto.
Perché la trasmissione dei dati in Internet avviene a pacchetti
I motivi fondamentali sono i seguenti:
-
Per multiplexare la trasmissione dei dati su Internet e quindi avere trasmissioni
"simultanee" di varie sequenze di dati appartenenti ad esempio ad utenti diversi;
ma anche ad applicazioni diverse di uno stesso utente (in generale, appartenenti a
processi (= programma in esecuzione) diversi);
-
Ad ogni momento, la rete può scegliere la strada migliore (più veloce) per
instradare i pacchetti. Accade quindi che durante la trasmissione di un file parte del
file raggiunga la destinazione attraverso una strada e l'altra parte attraverso un'altra
strada;
-
È più efficiente controllare gli errori di trasmissione:
-
È possibile implementare il Priority Tasking; ovvero, dare precedenza di
trasmissione ai "dati più importanti".
Come viene determinato univocamente ciascun computer della rete: l'indirizzo IP.
La sigla IP - che indica uno dei protocolli parlati su Internet - è solitamente
usata per indicare anche quel numero binario di 32 bits (4 bytes) che identifica
univocamente un qualsiasi computer connesso a Internet, e che andrebbe più
correttamente detto indirizzo IP.
Questo numero è definito in modo da contenere almeno un qualche indizio sulla
collocazione fisica del computer a cui si riferisce, in modo da facilitare le operazioni
di instradamento dei pacchetti. Di solito l'indirizzo IP si rappresenta con quattro cifre
decimali, da 0 a 28-1=255, separate da punti (ad
esempio, 151.90.23.2 è un indirizzo IP). Un pacchetto viene smistato leggendo
questo numero da sinistra verso destra, analogamente a quanto avviene per la posta
normale. Ciò secondo lo schema definito sopra.
Si noti che essendo un indirizzo IP costituito da 32 bits, il numero massimo di computers
di Internet deve essere non superiore a 232=4 294 967
296. Questo perché a macchine differenti devono essere associati indirizzi IP
differenti e tutte le possibili parole binarie lunghe 32 bits sono proprio 232. È già cominciata la transizione dall'attuale IP
versione 4 all'IP versione 6 (o IP Next Generation) che permetterà di avere ben 16
byte di indirizzo, contro i quattro attuali, e quindi avrà teoricamente posto per
un numero di computer pari a 2128=340 282 366 920 938
463 463 374 607 431 768 211 456.
Un computer collegato in permanenza alla rete, come visto, è univocamente
identificato da un numero detto indirizzo IP. Tuttavia, al giorno d'oggi, moltissimi
utenti utilizzano una connessione diretta ad un ISP (Internet Service Provider) via linea
commutata, ossia si collegano alla rete via telefono e modem. In questo caso, il PC
dell'utente è connesso a Internet soltanto saltuariamente, ossia quando l'utente si
collega con il server via telefono; nei periodi in cui esso è connesso, è
comunque necessario che il computer disponga di un proprio indirizzo IP, in modo da poter
essere individuato dal resto della rete e scambiare dati con essa. In questo caso, per
"risparmiare indirizzi IP", tale indirizzo è allocato dinamicamente (volgarmente
l'indirizzo prende il nome di IP dinamico) ogni volta che l'utente si collega al provider.
Ciò implica che ad ogni connessione un utente possa avere indirizzi IP differenti.
È naturale che, quando un utente deve accedere ad una risorsa di Internet, egli o
ella debba conoscere l'indirizzo IP della risorsa; proprio come, per telefonare ad una
persona, bisogna conoscere il numedro di telefono della persona. Siccome ricordarsi un
numero di 12 cifre risulta scomodo, è stato inventato un sistema più comodo
chiamato DNS.
Che cosa è il DNS (Domain Name System).
Il DNS è un sistema che permette di associare ad un indirizzo IP numerico (ad
esempio, 131.175.7.10) un indirizzo letterale (chiamato DNS) mnemonico del tipo
"nome_macchina.dominio_III_livello.dominio_II_livello.dominio_I_livello"
(ad esempio cdcsun.cdc.polimi.it). Tale sistema si basa sull'esistenza di computer di
servizio, detti name server o DNS server, che vengono interpellati ogni volta che si rende
necessaria una traduzione da un indirizzo DNS ad un indirizzo IP.
Poiché è impensabile che un name server conservi un elenco di tutti i nomi
letterali con relativo IP, la traduzione avviene in forma distribuita. Ad esempio,
supponiamo di voler accedere all'indirizzo pong.engr.orst.edu. Per prima cosa, il
programma di comunicazione del sistema operativo del nostro computer interpella il nostro
name server definito nella configurazione, il quale conserva un elenco di tutti i domini
di primo livello associati ad un altro name server; il nostro name server cercherà
il dominio edu e restituirà l'IP del name server ad esso associato. Il nostro
computer contatterà allora questo server, che conserverà un elenco di tutti
i domini di secondo livello situati dentro edu, e che segnalerà l'indirizzo IP del
server per il sottodominio orst.edu. Contattando questo ulteriore server, il nostro
computer riceverà l'IP del server per il sottodominio engr.orst.edu; contattando
tale server, finalmente il nostro computer riuscirà a sapere l'IP del computer
pong.
Poiché tutto ciò è lungo e complicato, esistono alcune scorciatoie.
Innanzi tutto non esiste mai un solo name server per dominio, per evitare che, in caso
esso smetta di funzionare, il dominio venga tagliato fuori dalla rete. Inoltre, i name
server sono capaci di imparare: dopo aver svolto per la prima volta tutta la trafila di
cui sopra, il nostro server memorizzerà gli IP dei vari server intermedi incontrati
lungo il cammino, associati al relativo sottodominio, e nel caso di future richieste per
gli stessi sottodomini si rivolgerà direttamente a loro. Per questo motivo,
solitamente si "saltano" vari livelli nella procedura, e rivolgendosi a uno o al
più due server diversi è possibile ritrovare l'IP del computer. Tuttavia,
le associazioni tra indirizzo IP e nome letterale vengono automaticamente eliminate dopo
un periodo di tempo prefissato, in modo da costringere il name server a ripetere la
trafila e quindi a controllare se per caso l'IP associato a quel nome è cambiato
nel frattempo.
All'interno del DNS è possibile definire degli alias, ossia equivalenze tra un nome
letterale ed un altro nome letterale, utili per semplificare gli indirizzi letterali o per
avere più indirizzi letterali associati ad un singolo computer. Questa
possibilità è utilizzata normalmente per concentrare un certo numero di
servizi sullo stesso computer: ad esempio, poiché per ragioni di convenienza
generale si è soliti porre il sito FTP di un'ente sullo stesso computer in cui
è posto il suo sito WWW, il nome ftp.azienda.com e il nome www.azienda.com
individuano solitamente lo stesso computer che ad esempio ha indirizzo DNS
pippo.azienda.tiscalinet.it.
Per approfondire si veda Internet & Computing Italian FAQ di V. Bertola,
Capitolo 13.
Che cosa è l'indirizzo URL (Uniform Resorce Locator).
Per poter recuperare un qualsiasi oggetto posto in rete è necessario conoscere:
-
Dove è situato (ossia il nome della macchina, il percorso sull'hard disk della
macchina e il nome del file);
-
Con che protocollo esso può essere recuperato.
Per racchiudere in un unico "indirizzo" tutte queste informazioni è stato creato uno
schema detto URL (Uniform Resource Locator, ossia Localizzatore Uniforme di Risorse). Un
URL assume normalmente la forma seguente:
metodo://nomemacchina:porta/nomeoggetto
(ad esempio, "http://www.apav.it/nucleoricerca.htm" oppure
"ftp://ftp.sunet.se/pub/3dk24.zip", eccetera) dove il metodo (di accesso alla risorsa,
anche detto schema) può valere solitamente http, ftp, telnet, news, mailto o file a
seconda del protocollo che si deve utilizzare; il nomemacchina è il nome (letterale
o IP) del computer su cui si trova l'oggetto; la porta (solitamente sottintesa, nel qual
caso si assume un valore standard che varia a seconda del protocollo scelto) è il
numero della porta (è un numero da 0 a 216-1=65535) con cui si intende comunicare con la macchina il
nomeoggetto è il nome completo (percorso sull'hard disk della macchina compreso il
nome del file) dell'oggetto.
Per approfondire si veda Internet & Computing Italian FAQ di V. Bertola,
Paragrafo 3.4.
Che cosa è l'E-mail (Electronic mail).
Si veda Internet & Computing Italian FAQ di V. Bertola,
Paragrafo 3.10.
Che cosa è una mailing list (lista di e-mail).
Si veda Internet & Computing Italian FAQ di V. Bertola,
Paragrafo 3.11.
Che cosa è un newsgroup.
Si veda Internet & Computing Italian FAQ di V. Bertola,
Paragrafo 3.12.
Come si ricerca su Internet: i motori di ricerca e gli indici di rete.
Si veda Internet & Computing Italian FAQ di V. Bertola,
Paragrafo 6.2 e
Paragrafo 6.3.
Riferimenti:
- Internet & Computing Italian FAQ di V. Bertola,
Capitolo 2.
- Internet & Computing Italian FAQ di V. Bertola,
Capitolo 3 I parte.
- Internet & Computing Italian FAQ di V. Bertola,
Capitolo 3 II parte.
- Internet & Computing Italian FAQ di V. Bertola,
Capitolo 5.
- Internet & Computing Italian FAQ di V. Bertola,
Capitolo 6.
- Internet & Computing Italian FAQ di V. Bertola,
Capitolo 13.
Esci.